シリーズ · 全 3 部
判断だけを返すモデル Jev を、自分のブログで測る
文章ではなく型と確率を返すモデル Jev に、自分のブログのタグ付けを任せて測った3部構成の記録。何を返すモデルかから始め、正誤が付かなかった題材、確率が何に反応しているか、確率の上に載せた自作の規則の揺れまでを、実際に送った数字で追う。
こんな人におすすめ
- LLM の API を呼んだことがあり、分類やタグ付けのような判断をモデルに任せたい開発者
- Jev / TypeSafe を知らないが、文章ではなく型で答えるモデルがどう使えるかを知りたい人
- モデルの評価を、公開ベンチマークではなく自分の題材で確かめたい人
推奨読書順
Part 1
 Jev とは何か — ブログ57記事のタグ付けを任せたら、正誤が付かなかったJev は文章ではなく、はい/いいえの確率や選択肢で答える判断モデルです。何を返すモデルかを整理したうえで、自分のブログ57記事のタグ付けを Jev と Haiku に任せ、答えが割れた38件を書き手の私がどちらが妥当か判断しました。カテゴリ28件はすべて「どちらも妥当」で、タグ付けは正誤のある分類問題ではありませんでした。13,794 文字|28 分
Part 2
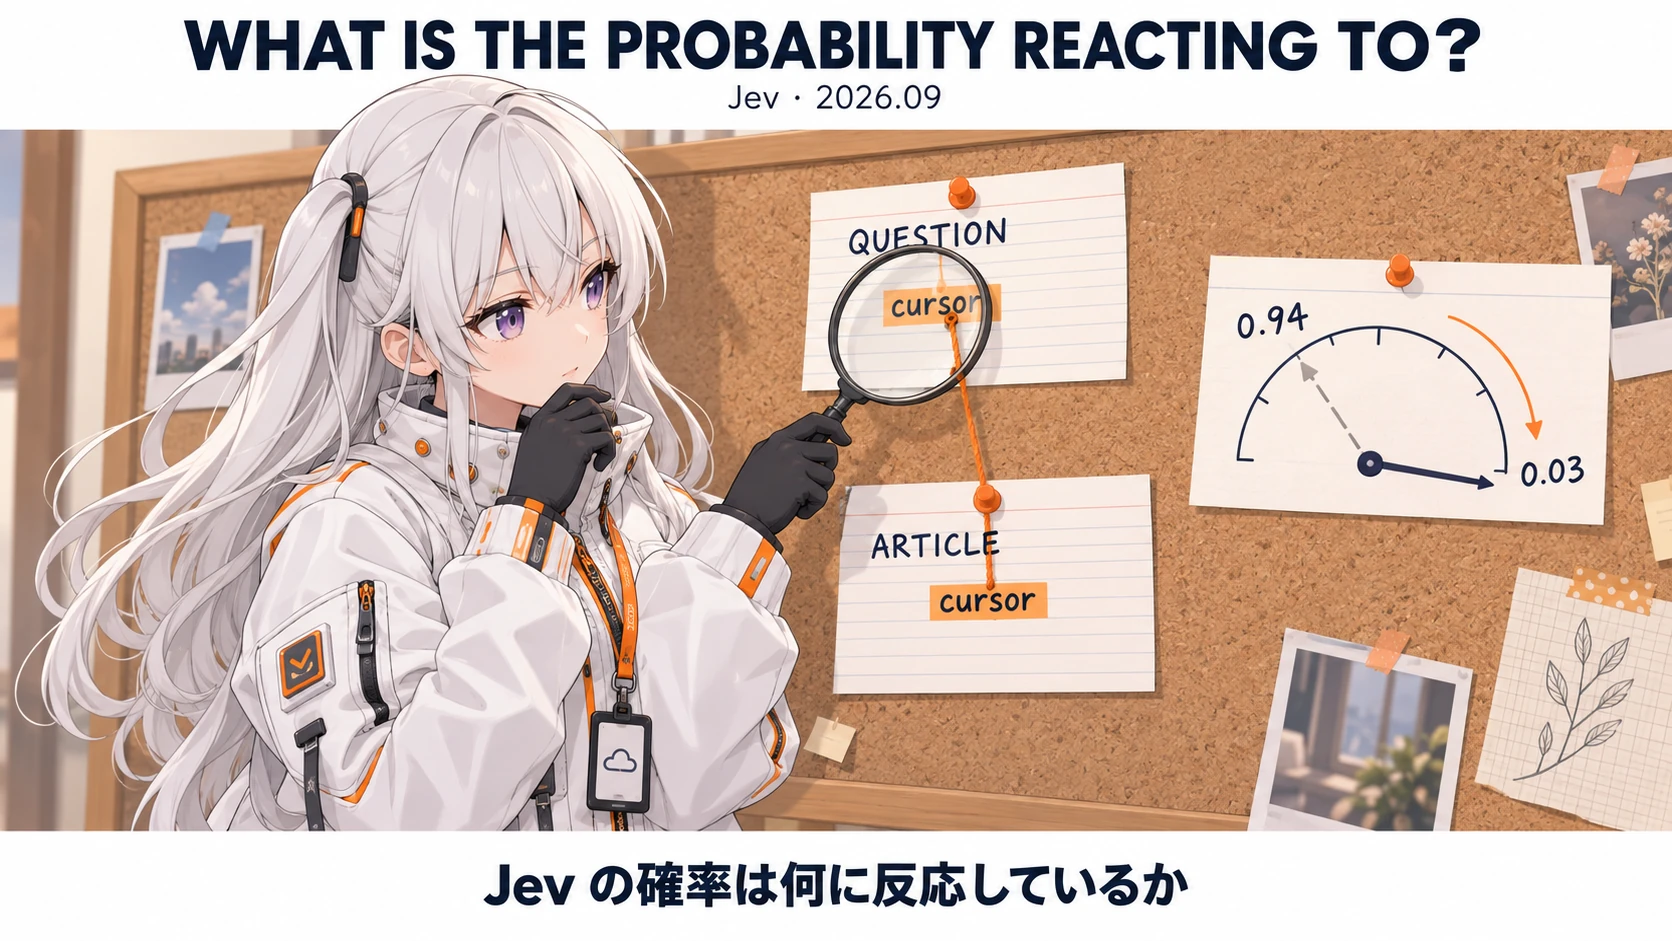 Jev の確率は何に反応しているか — 質問文から名前を消したら 0.81 が 0.03 になった名前は出てくるのに中身は違う記事と、中身も同じ記事の計20件に、質問文を6通り当てて切り分けました。Jev が反応していたのは本文の語そのものではなく、質問文の語と本文の語の一致でした。公式の弱点一覧に無い挙動と、そこから出てくる質問文の書き方3つをまとめます。8,209 文字|17 分
Part 3
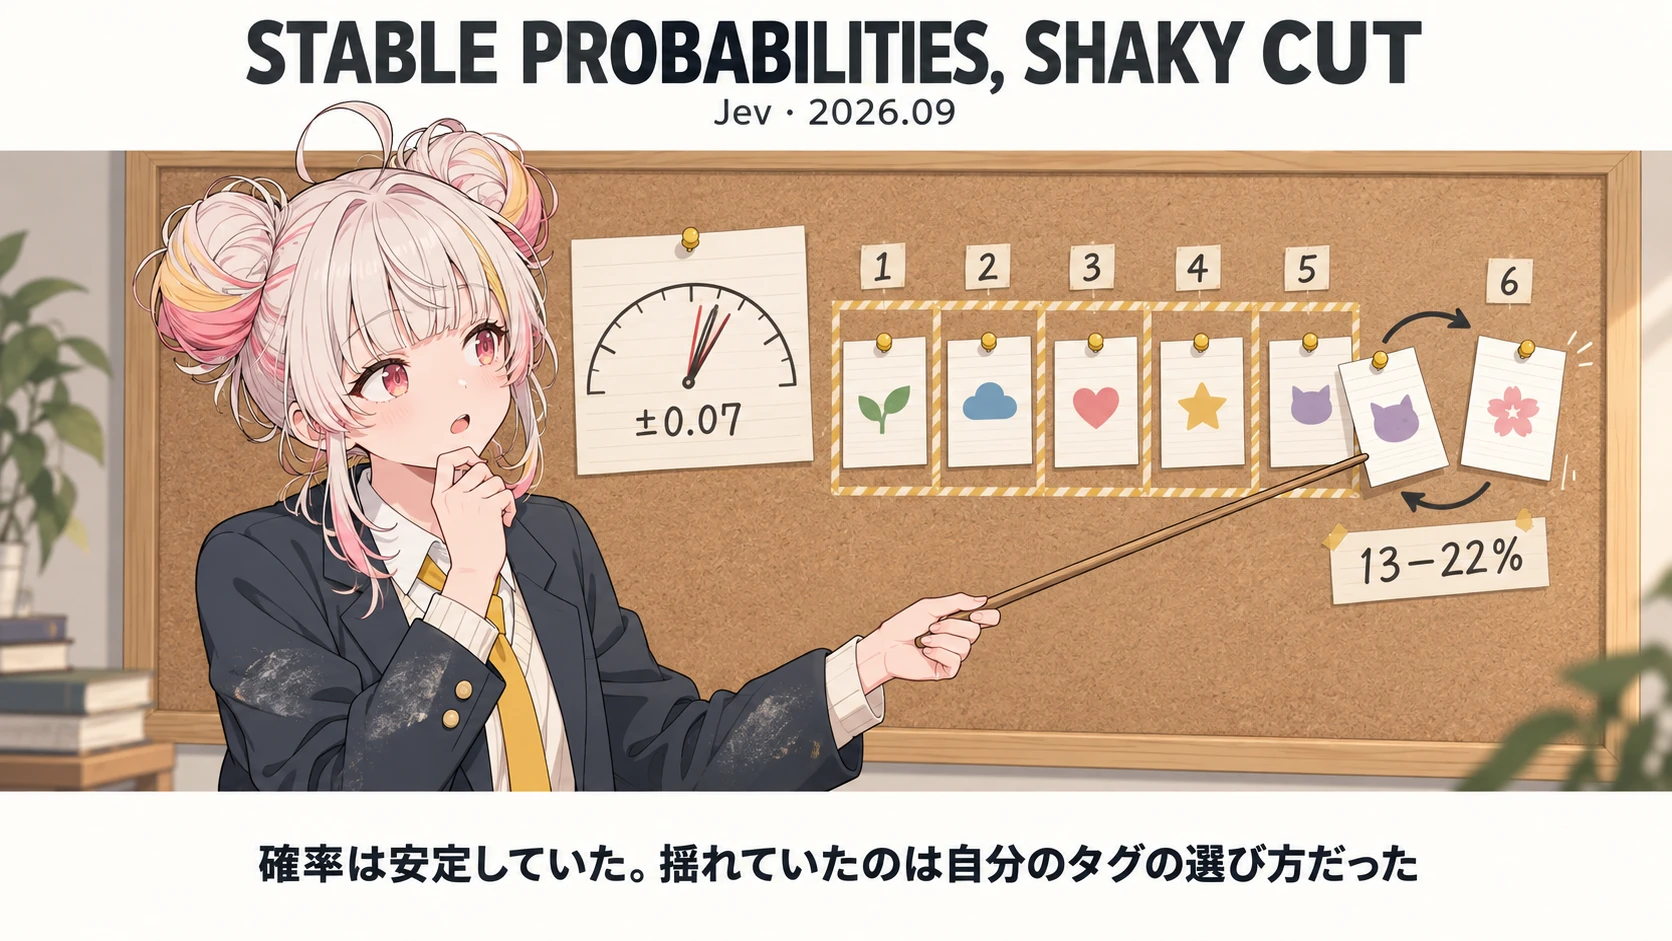 確率は安定していた。揺れていたのは自分のタグの選び方だった小さな判断モデルに同じ23件を3回送ると、確率の差は最大0.07でした。それでも、確率の上位5個を取る自作のタグの選び方で選んだタグは、1回の再実行で13〜22%の記事で入れ替わりました。疑う場所はモデルより、自分で書いたタグの選び方でした。7,927 文字|16 分