カテゴリー
タグ
bunrustanthropicclaude-codecoding-agenttypescriptci-cdastroweb-developmentai-agentdeveloper-experiencecodexopenaiagent-skillsimage-generationaillmbenchmarkopen-sourcegooglecssglmclaudereviewnano-bananacost-analysisprompt-engineeringevaluationproductiontransformerpythonqwenollamaantigravitygpt-5rag
ZeroZawa
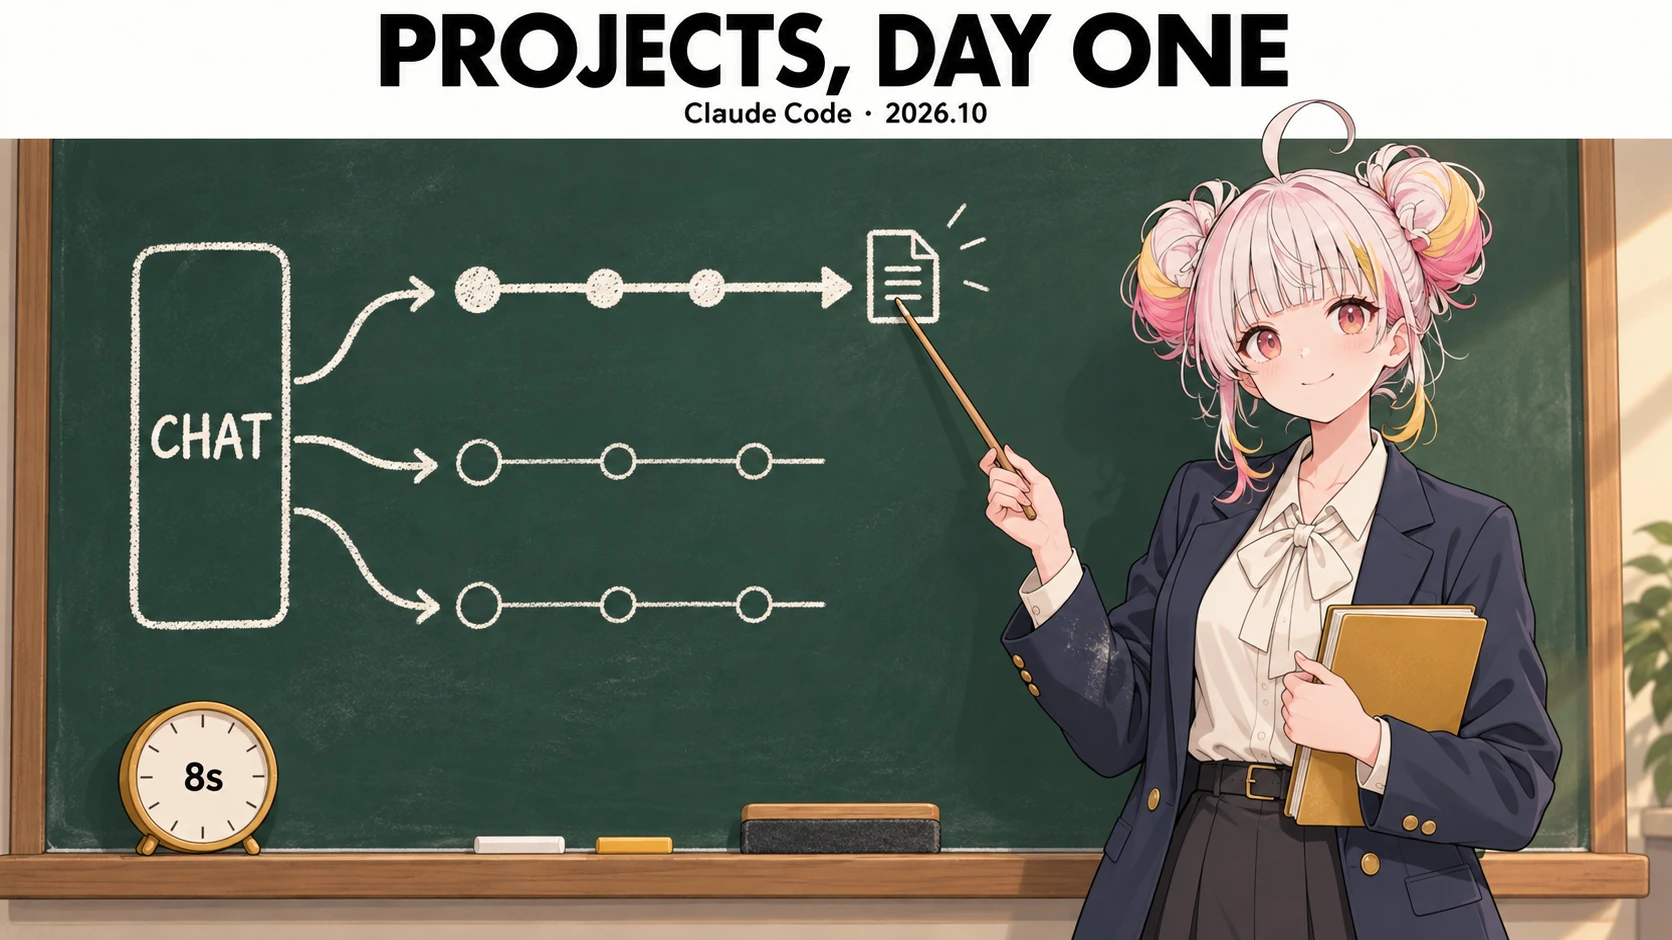
Claude Code の Projects に、Projects の記事を書かせてみた——初日の実録
2026年9月にベータ公開された Claude Code の新しい Projects を使い始めた初日に、この機能自体を紹介する記事の下書きを Projects に任せました。コーディネーターとスレッドの分業がどう動いたかを、プロジェクトチャットの時刻とスレッドの作業記録から秒単位で追い、リポジトリを3つつないだときに何が測れて何が測れないのかを整理します。
5,485 文字
|
11 分
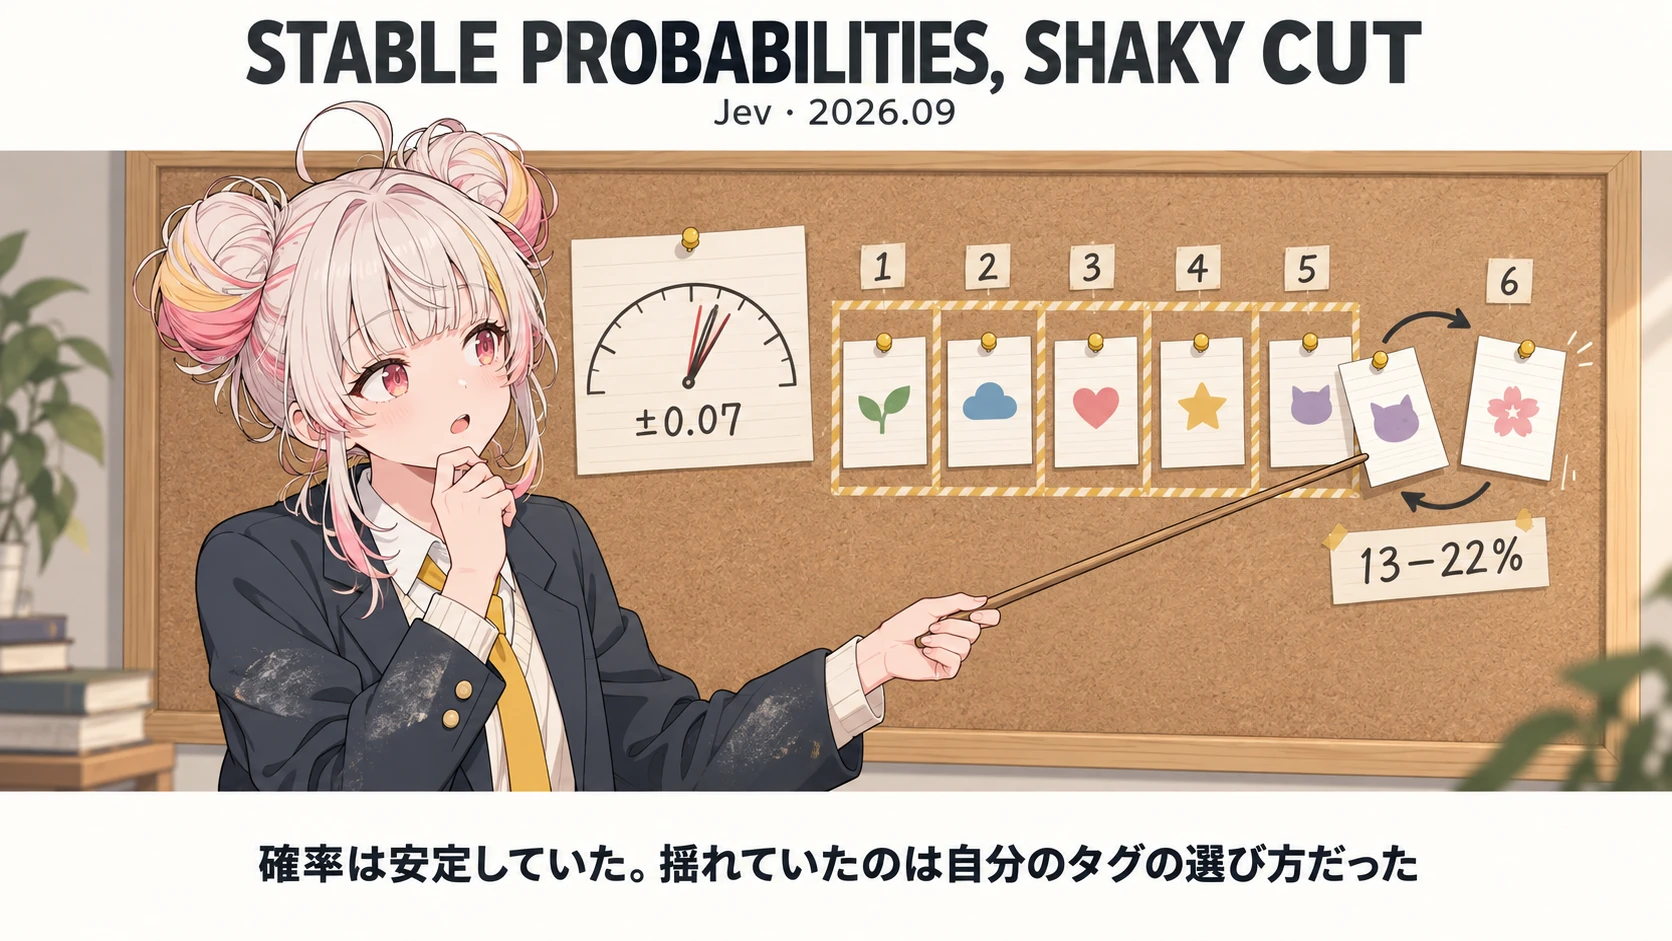
確率は安定していた。揺れていたのは自分のタグの選び方だった
小さな判断モデルに同じ23件を3回送ると、確率の差は最大0.07でした。それでも、確率の上位5個を取る自作のタグの選び方で選んだタグは、1回の再実行で13〜22%の記事で入れ替わりました。疑う場所はモデルより、自分で書いたタグの選び方でした。
7,927 文字
|
16 分
Jev の確率は何に反応しているか — 質問文から名前を消したら 0.81 が 0.03 になった
名前は出てくるのに中身は違う記事と、中身も同じ記事の計20件に、質問文を6通り当てて切り分けました。Jev が反応していたのは本文の語そのものではなく、質問文の語と本文の語の一致でした。公式の弱点一覧に無い挙動と、そこから出てくる質問文の書き方3つをまとめます。
8,209 文字
|
17 分
Jev とは何か — ブログ57記事のタグ付けを任せたら、正誤が付かなかった
Jev は文章ではなく、はい/いいえの確率や選択肢で答える判断モデルです。何を返すモデルかを整理したうえで、自分のブログ57記事のタグ付けを Jev と Haiku に任せ、答えが割れた38件を書き手の私がどちらが妥当か判断しました。カテゴリ28件はすべて「どちらも妥当」で、タグ付けは正誤のある分類問題ではありませんでした。
13,794 文字
|
28 分
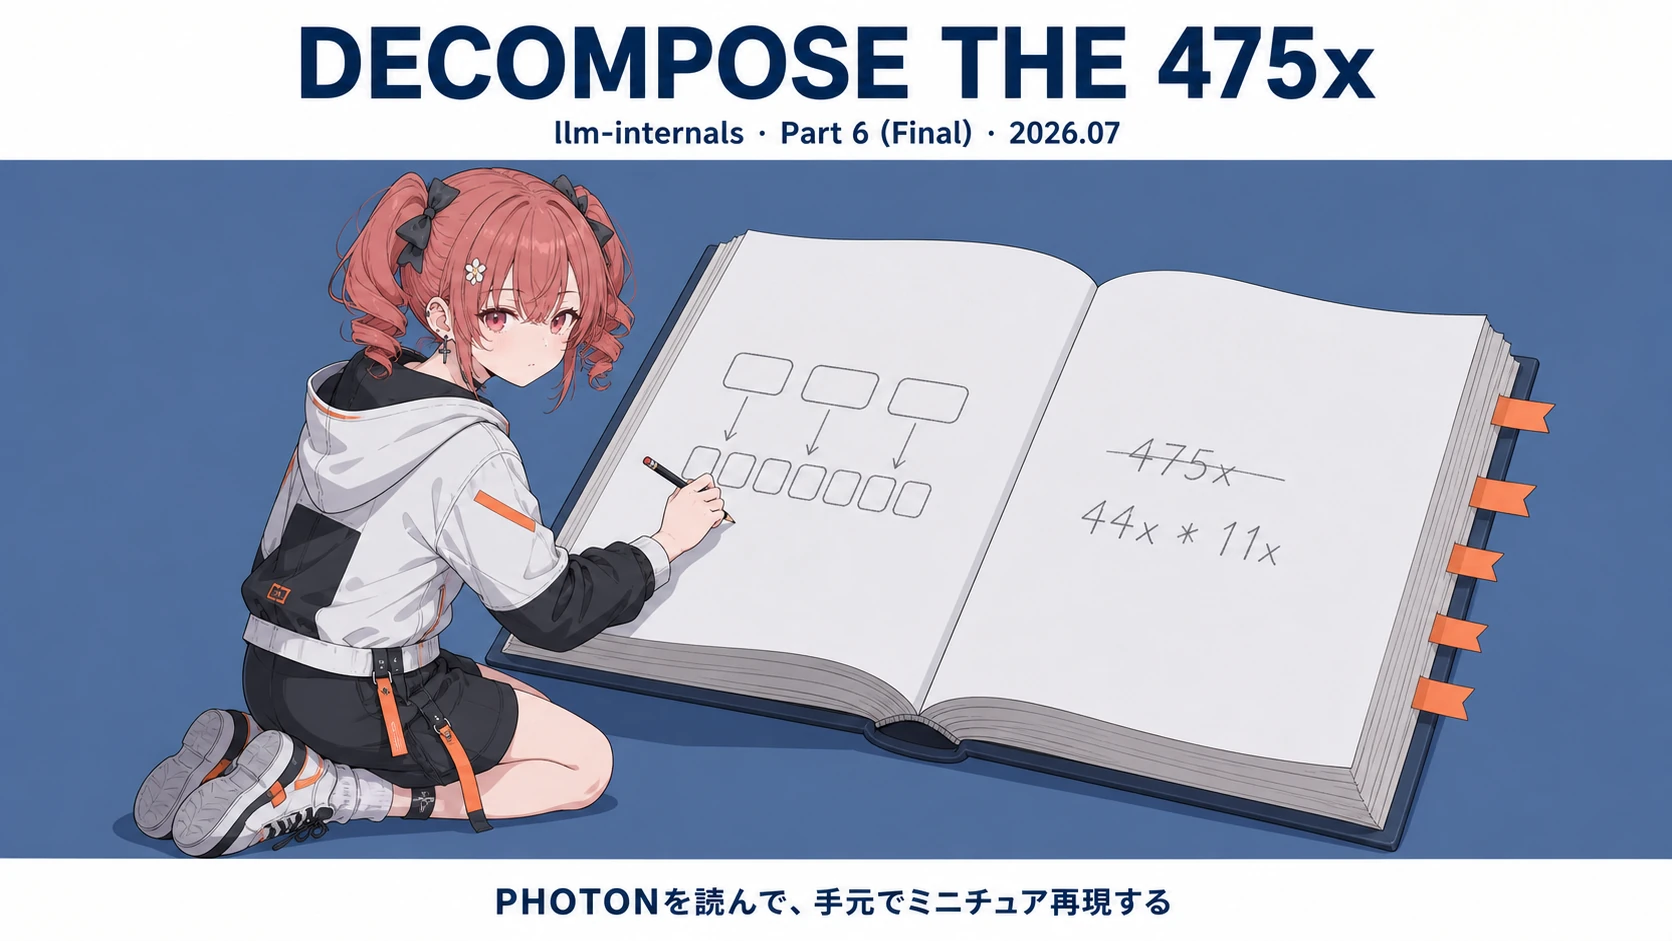
PHOTON を読んで、手元でミニチュア再現する — 475 倍をスループット×メモリに分解し、チャンク階層を自分で測る
富士通 PHOTON は「GPU リソース当たり最大 475 倍」を謳いますが、これはスループット÷メモリの合成値です。実スループットは約 44 倍、メモリ削減は約 11 倍とその内訳を分解し、源泉であるチャンク階層構造(bottom-up encoder + top-down decoder)をミニチュアで自作します。Part 5 の nanoGPT 級モデルと3 seedで比較した、小規模な一実験の観察として、PPL・スループット・メモリのどれが再現でき、どれが規模に依存するのかを自分の手元で確かめます。連載「言語モデルの中身」最終回・Part 6。
10,454 文字
|
21 分